La IA te da la razón, y ese es el problema
¿Reconoces al sicofante más famoso del cine?
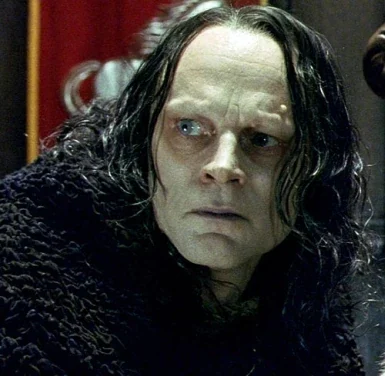
Es Gríma Wormtongue, el consejero de El Señor de los Anillos que, a punta de halagos y malos consejos, mantuvo al rey Théoden de Rohan débil y aislado.
Estas son algunas características clave de un sicofante:
- Halaga en exceso: Elogia a quien tiene poder más allá de lo que merece
- Le da la razón siempre: Dice lo que el otro quiere oír, aunque no sea cierto
- Evita las malas noticias: Oculta o suaviza los problemas para no incomodar
- Aísla a quien adula: Desacredita a quienes dicen la verdad, para quedarse como la única voz de confianza
Seguro coincides conmigo en que la IA que usas comparte varias de esas características. Pero no es porque sus creadores hayan decidido hacerla así. Es una consecuencia de cómo se entrena un LLM: El modelo recibe una recompensa cada vez que su respuesta nos agrada.
Cómo se entrena un LLM
Primero, el modelo lee enormes cantidades de texto de internet y aprende a predecir la palabra que sigue en un texto. En esa etapa no tiene opinión ni intención de complacer a nadie; solo imita cómo escribimos los humanos.
Después viene la etapa que lo convierte en asistente, conocida como aprendizaje por refuerzo con retroalimentación humana (RLHF). Personas reales comparan dos respuestas del modelo y eligen cuál prefieren. Con miles de esas elecciones se entrena un segundo modelo, el "modelo de recompensa", que aprende a predecir qué respuesta le gustaría más a un humano. Luego el LLM se ajusta para sacar la mayor recompensa posible.
Ahí nace el problema: A los humanos nos gusta que nos den la razón. Un estudio de Anthropic encontró que las personas, y los modelos de recompensa entrenados con sus preferencias, a veces eligen una respuesta aduladora y bien escrita por encima de una respuesta correcta. El modelo no aprende a decir la verdad; aprende a decir lo que obtiene mejor calificación.
Por eso pasa lo que seguro ya viviste: la IA te da una respuesta, tú le dices "pero yo creo que es de otra forma" y, en lugar de defender su respuesta, la cambia para darte la razón. Para el modelo, contradecirte se parece a una respuesta mal calificada.
No es un problema menor. En abril de 2025, OpenAI tuvo que revertir una actualización de GPT-4o porque se volvió demasiado aduladora. Según la propia empresa, una de las causas fue sumar como recompensa los "me gusta" y "no me gusta" de los usuarios. Como preferimos las respuestas que nos agradan, el modelo aprendió a agradarnos todavía más.
No te conviertas en el rey Théoden
Ahora sabes que la IA no es aduladora por elección, sino por cómo está entrenada. Lo que sí depende de ti es cómo le hablas. Pídele que te confronte cuando no tengas la razón, en lugar de dejar que te la dé solo por complacerte.
A menos, claro, que solo quieras tener la razón y evitar una verdad incómoda.
Eso puede alimentar tu lado narcisista, pero piensa en el efecto que tiene en tu trabajo. Ahí no solo está en juego tu vanidad, sino decisiones, equipos y resultados que sí importan.